Una de las partes más importantes cuando desarrollamos sistemas de trading con StrategyQuant X es comprobar qué ocurre cuando una estrategia deja de trabajar sobre los datos utilizados durante su creación.
Podemos generar una estrategia con una curva excelente, un buen Profit Factor y un drawdown reducido, pero todo eso sigue perteneciendo al histórico que hemos utilizado durante el proceso de desarrollo.
La pregunta realmente interesante es otra:
¿Qué ocurre cuando enfrentamos esa estrategia a datos que no se utilizaron para crearla?
Aquí entra en juego el Out of Sample (OOS).
En mi metodología utilizo diferentes niveles de datos fuera de muestra. Primero realizo una validación dentro del propio Builder y posteriormente incorporo un periodo completamente desconocido para las estrategias, lo que denomino True Out of Sample.
Pero además utilizo estos datos para algo que considero todavía más interesante: investigar qué configuraciones de StrategyQuant producen sistemas capaces de mantener mejor su ventaja cuando cambia el periodo histórico.
En este artículo voy a explicarte cómo lo hago.
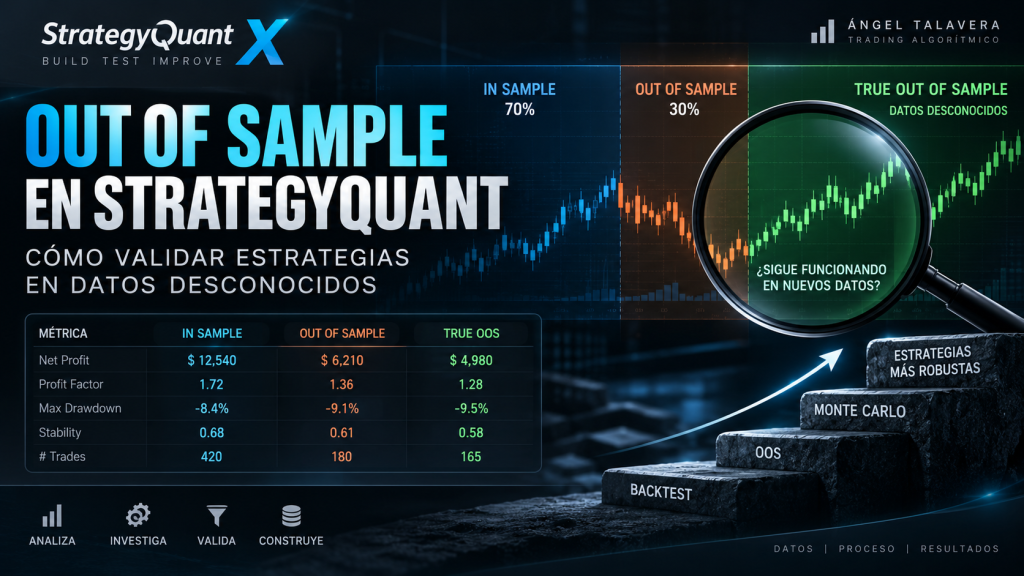
Qué significa In Sample y Out of Sample en StrategyQuant X
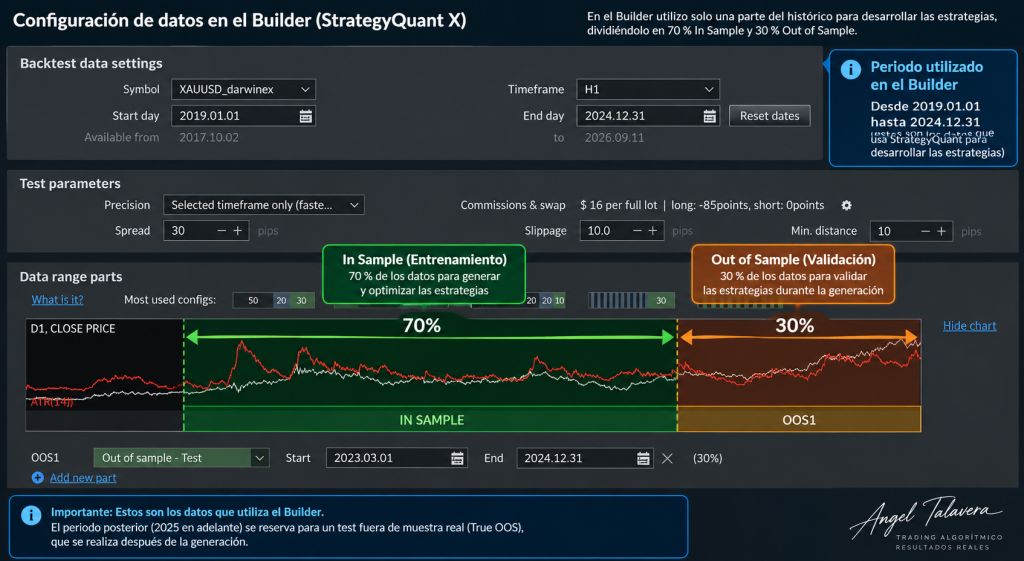
Cuando configuramos una generación en el Builder podemos dividir el histórico en diferentes zonas.
En mi caso, una configuración habitual es:
- 70 % In Sample (IS)
- 30 % Out of Sample (OOS)
El In Sample es la zona donde StrategyQuant busca patrones y desarrolla las estrategias.
El Out of Sample es una parte del histórico que utilizamos como primera validación durante ese mismo proceso.
La idea es bastante sencilla.
Si StrategyQuant encuentra una determinada combinación de reglas utilizando los datos de entrenamiento, quiero empezar a observar qué ocurre cuando esa misma estrategia entra en una zona diferente.
No espero necesariamente que IS y OOS produzcan exactamente los mismos resultados.
Lo que busco es que exista coherencia entre ambos periodos.
No busco el mejor resultado en In Sample
Uno de los errores que podemos cometer al generar estrategias es centrarnos exclusivamente en encontrar aquellas que muestran los mejores resultados históricos.
Para mí eso no es suficiente.
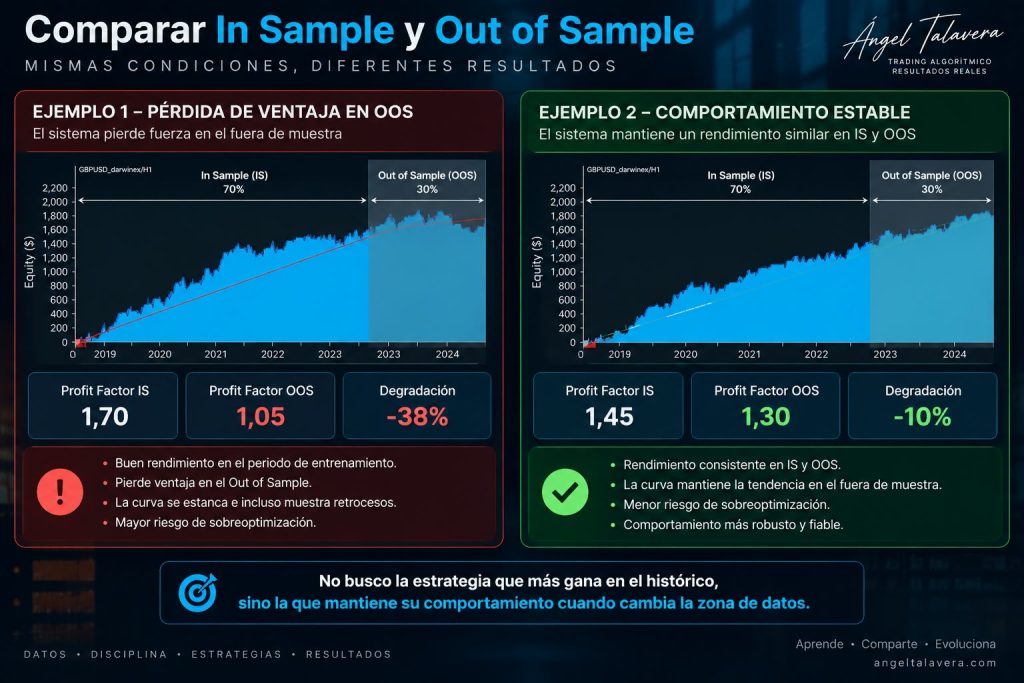
Imagina estas dos situaciones.
Una primera estrategia presenta:
Profit Factor IS: 1,70
Profit Factor OOS: 1,05
Continúa siendo positiva en el Out of Sample, pero la degradación es considerable.
Ahora tenemos otra estrategia:
Profit Factor IS: 1,45
Profit Factor OOS: 1,30
Su Profit Factor inicial es inferior, pero cuando cambiamos de zona de datos mantiene mucho mejor su comportamiento.
Entre ambas situaciones, la segunda me resulta mucho más interesante.
No estoy buscando simplemente la estrategia que más gana en los datos utilizados para desarrollarla.
Estoy intentando encontrar sistemas cuya ventaja no dependa excesivamente de esa zona concreta del histórico.
Medir la degradación entre In Sample y Out of Sample
Esta comparación entre IS y OOS podemos llevarla a las métricas.
Si tenemos:
PF IS = 1,70
PF OOS = 1,05
la degradación aproximada sería:
(1,70 – 1,05) / 1,70 = 38,2 %
Mientras que:
PF IS = 1,45
PF OOS = 1,30
representaría aproximadamente:
(1,45 – 1,30) / 1,45 = 10,3 %
Esto no significa que exista un porcentaje mágico que determine automáticamente si una estrategia es buena o mala.
Lo que me interesa es disponer de ratios objetivos que me permitan comparar sistemas bajo los mismos criterios.
Podemos aplicar este razonamiento a diferentes estadísticas:
- Profit Factor.
- CAGR.
- Stability.
- Sharpe Ratio.
- Average Trade.
- Drawdown.
- Número de operaciones.
La idea es observar cuánto cambia el comportamiento cuando pasamos de entrenamiento a validación.
Cuanto mayor sea la diferencia, más motivos tengo para investigar qué está ocurriendo.
Out of Sample del Builder y True Out of Sample no son lo mismo
Aquí quiero hacer una distinción importante dentro de mi metodología.
Utilizo dos conceptos diferentes:
Out of Sample del Builder
Forma parte del periodo configurado durante la generación.
Por ejemplo:
2019–2024
Dentro de ese histórico puedo utilizar aproximadamente:
70 % IS + 30 % OOS
El OOS me proporciona una primera validación mientras StrategyQuant está desarrollando las estrategias.
True Out of Sample
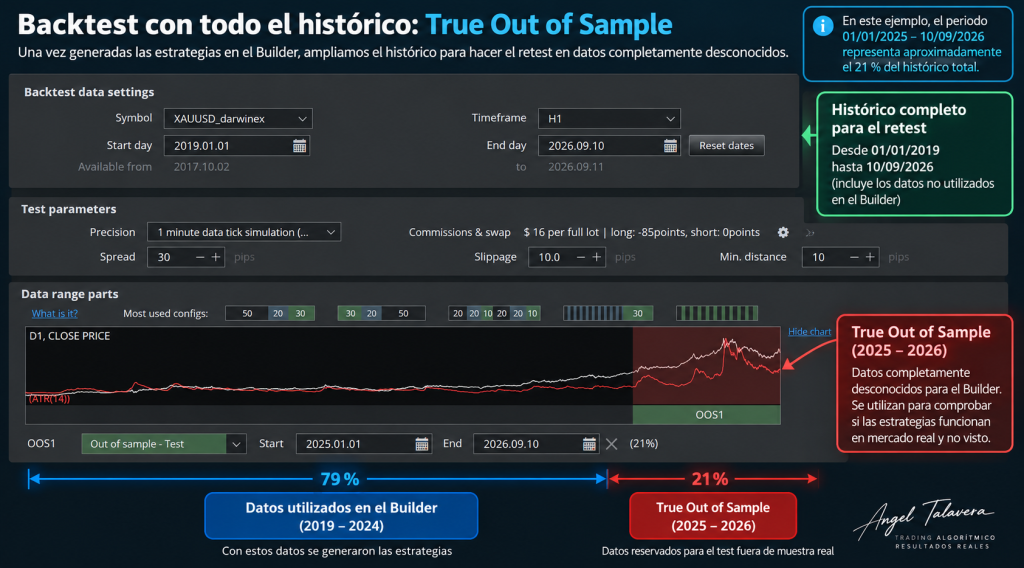
Después dejo una parte adicional del histórico completamente fuera de la generación.
StrategyQuant no utiliza esos datos durante el desarrollo.
Una vez terminada la minería, amplío las fechas mediante el Retester e incorporo ese nuevo periodo.
Por ejemplo:
Builder: hasta 31/12/2024
True OOS: 01/01/2025 – 10/09/2026
Ahora estamos mostrando a las estrategias un periodo que no conocían cuando fueron creadas.
Por qué considero tan importante el True Out of Sample
Aquí cambia completamente la pregunta que estamos haciendo.
Ya no quiero saber:
¿Qué estrategia obtuvo mejores resultados durante la generación?
Ahora quiero saber:
¿Cuántas estrategias continúan mostrando ventaja cuando las enfrentamos a mercado que nunca habían visto?
Para mí esta es una de las pruebas más valiosas de todo el proceso.
El mercado siempre tendrá condiciones diferentes.
Una estrategia puede haber encontrado una ventaja durante un periodo determinado y perderla posteriormente.
Por eso reservar datos me permite realizar una comprobación mucho más interesante antes de continuar gastando recursos en pruebas más exigentes.
En el proyecto que utilicé para explicar mi proceso completo partimos de:
3.203 estrategias
Después de enfrentarlas a nuevos datos quedaron:
1.646 estrategias
Prácticamente la mitad desapareció simplemente al cambiar el periodo histórico.
Eso no significa que las 1.646 restantes vayan a funcionar en el futuro.
Significa algo mucho más concreto:
han conseguido mantener unas condiciones mínimas cuando las hemos enfrentado a información que no participó en su desarrollo.
Y para mí eso es suficiente para permitirles pasar al siguiente test.
Si quieres ver cómo encaja esta prueba dentro de todo mi proceso:
👉 Cómo crear estrategias con StrategyQuant X paso a paso
Utilizar nuevos datos para investigar configuraciones de StrategyQuant
Hasta aquí podríamos utilizar el OOS simplemente como un filtro.
Pasa / no pasa.
Pero podemos obtener mucha más información.
Una de las cosas que hago actualmente es utilizar el True Out of Sample como herramienta de investigación.
Cuando realizo diferentes minerías guardo información sobre cómo estaba configurado cada proyecto.
Después puedo comparar cuántas estrategias sobreviven cuando modificamos pequeñas partes de esa configuración.
Aquí es donde StrategyQuant empieza a convertirse, para mí, en algo más que un generador de sistemas.
Se convierte en un laboratorio de investigación cuantitativa.
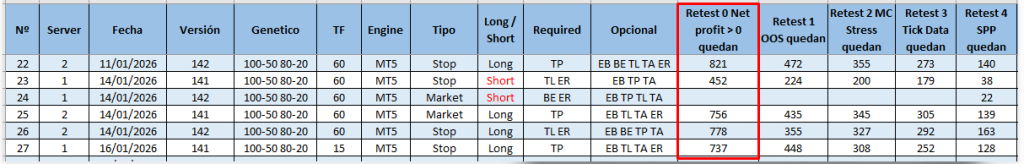
Retest 0: ¿cuántas estrategias continúan ganando en nuevos datos?
Dentro de mi proceso utilizo una primera prueba que denomino Retest 0.
La condición es deliberadamente sencilla:
Net Profit > 0 $ en nuevos datos.
No estoy diciendo que una estrategia que gane 1 $ sea robusta.
Evidentemente no lo es por superar únicamente este criterio.
Lo que quiero medir en este momento es otra cosa:
¿Cuántas estrategias de una determinada minería consiguen seguir siendo positivas cuando cambiamos a datos desconocidos?
Eso me proporciona una métrica sencilla que puedo utilizar para comparar diferentes investigaciones.
Comparar configuraciones en lugar de elegirlas por intuición
Aquí es donde este proceso empieza a aportar información realmente interesante.
Puedo mantener prácticamente toda la configuración igual y modificar solamente una variable.
Después genero una muestra suficientemente grande y observo qué ocurre en nuevos datos.
Por ejemplo, puedo comparar diferentes tipos de entrada:
- Market.
- Stop.
- Limit.
También puedo separar:
- Long.
- Short.
O comparar diferentes temporalidades:
- M15.
- H1.
- Otras configuraciones.
Pero también puedo investigar las reglas utilizadas para cerrar las operaciones.
Entre las configuraciones que puedo estudiar encontramos:
TP — Take Profit
Salida mediante un objetivo de beneficio.
TL — Trailing Stop
El stop acompaña al precio cuando la operación avanza favorablemente.
TA — Trailing Activation
Condición utilizada para determinar cuándo comienza a actuar el trailing.
EB — Exit Bars
La operación se cierra después de un determinado número de barras.
ER — Exit Rule
Salida basada en una regla lógica.
Puedo definir determinadas salidas como obligatorias y otras como opcionales y posteriormente estudiar cómo afecta esa decisión a la supervivencia de las estrategias.
Esto permite plantear preguntas concretas.
¿Funcionan mejor las entradas Stop o Market para este activo?
¿Las estrategias Long mantienen mejor su ventaja que las Short?
¿Qué ocurre si obligamos a utilizar Take Profit?
¿Qué combinación de reglas de salida produce sistemas que sobreviven mejor en nuevos datos?
Ya no tenemos que responder basándonos únicamente en nuestra percepción.
Podemos medirlo.
No comparar únicamente números absolutos
Hay otro punto importante.
Supongamos que una minería produce:
1.000 estrategias → 500 sobreviven
y otra:
600 estrategias → 400 sobreviven
Si observamos únicamente el número final podríamos pensar que la primera configuración es mejor porque conserva 500 estrategias frente a 400.
Pero si calculamos la supervivencia:
500 / 1.000 = 50 %
frente a:
400 / 600 = 66,7 %
la interpretación cambia completamente.
Por eso considero muy interesante trabajar también con porcentajes de supervivencia.
Podemos medir:
% supervivencia Retest 0
↓
% supervivencia OOS
↓
% supervivencia Monte Carlo
↓
% supervivencia Tick Data
↓
% supervivencia SPP
De esta forma podemos comparar proyectos aunque inicialmente hayan generado cantidades diferentes de estrategias.
Seguir las estrategias durante todo el embudo
En la tabla anterior puedes observar que no me limito a registrar el Retest 0.
Cada minería continúa avanzando por diferentes pruebas:
Retest 0
Net Profit > 0 $ en nuevos datos
↓
Retest 1
Validación OOS
↓
Retest 2
Monte Carlo Stress
↓
Retest 3
Tick Data
↓
Retest 4
SPP — System Parameter Permutation
Esto me permite estudiar no solamente qué configuración genera más estrategias.
Puedo analizar qué configuración produce estrategias que sobreviven mejor durante todo el proceso.
Esta diferencia es fundamental.
Una determinada plantilla puede generar cientos de estrategias aparentemente excelentes y después perder la mayoría cuando aparecen nuevos datos.
Otra configuración podría generar menos sistemas inicialmente, pero conseguir que un porcentaje mucho mayor llegue hasta las últimas pruebas.
Para mí, la segunda situación puede ser mucho más interesante.
El objetivo es convertir StrategyQuant en un proceso de investigación
Esta es una de las partes que más me interesa actualmente del trading algorítmico.
No quiero utilizar StrategyQuant simplemente así:
Configurar → generar → seleccionar la mejor curva.
Quiero trabajar de otra manera:
Hipótesis → configuración → generación → nuevos datos → medición → comparación → nueva hipótesis.
Por ejemplo:
Hipótesis
Las entradas Stop podrían adaptarse mejor que las Market a determinado activo.
Experimento
Genero dos minerías intentando mantener el resto de variables lo más parecido posible.
Validación
Las enfrento al mismo periodo desconocido.
Medición
Comparo:
- Número inicial.
- Supervivencia Retest 0.
- Supervivencia OOS.
- Monte Carlo.
- Tick Data.
- SPP.
Resultado
Obtengo información que puedo utilizar para diseñar la siguiente investigación.
Esto no demuestra que una configuración vaya a funcionar siempre mejor en el futuro.
Pero elimina una parte muy importante de la arbitrariedad.
Nada se deja al azar si podemos medirlo.
Out of Sample tampoco debe convertirse en otra optimización
Aquí aparece un riesgo que considero importante.
Si probamos continuamente diferentes configuraciones y elegimos siempre aquella que mejor funcionó en nuestro periodo OOS, podemos terminar optimizando indirectamente sobre el propio Out of Sample.
El OOS dejaría entonces de ser realmente independiente.
Por eso debemos diferenciar entre utilizar nuevos datos para investigar y utilizar repetidamente el mismo periodo para ajustar una estrategia concreta hasta conseguir que funcione.
No quiero modificar una estrategia una y otra vez hasta hacer que su OOS quede bonito.
Quiero analizar muestras de estrategias y procesos de generación.
Es una diferencia importante.
El objetivo del OOS no es proporcionarnos otro histórico donde optimizar.
Su objetivo es ofrecernos información sobre lo que ocurre cuando salimos de los datos utilizados durante el desarrollo.
Un sistema positivo en OOS todavía no es una estrategia robusta
Esta es otra idea fundamental.
Superar Out of Sample no convierte automáticamente una estrategia en apta para operar.
Una estrategia puede:
- Ser positiva en OOS.
- Tener una curva razonable.
- Mantener un Profit Factor aceptable.
y aun así fallar cuando modificamos:
- Los precios.
- El spread.
- El slippage.
- Los parámetros de los indicadores.
- La precisión de los datos.
Por eso Out of Sample es solamente una parte de mi metodología.
Después vienen pruebas diseñadas para responder a preguntas diferentes.
Una de las siguientes es Monte Carlo Stress.
Ahí dejamos de cambiar únicamente el periodo histórico y empezamos a alterar las propias condiciones bajo las que trabaja la estrategia.
Errores habituales al utilizar Out of Sample
Hay varios errores que intento evitar.
Utilizar todo el histórico durante el desarrollo
Si StrategyQuant ha utilizado todos los datos disponibles, después no tenemos un periodo realmente desconocido con el que comprobar el sistema.
Mirar únicamente si OOS termina en positivo
No me interesa solamente que el beneficio sea mayor que cero.
También quiero observar cómo se han degradado las métricas respecto al entrenamiento.
Exigir resultados idénticos entre IS y OOS
No espero que ambos periodos sean iguales.
Son mercados y momentos diferentes.
Busco coherencia, no una copia exacta.
Modificar la estrategia después de ver cada OOS
Si ajustamos constantemente el sistema para corregir lo que ocurrió fuera de muestra, terminaremos incorporando esa información al proceso de desarrollo.
Elegir configuraciones por una sola minería
Una muestra pequeña puede producir resultados engañosos.
Por eso me interesa acumular investigaciones y comparar resultados a lo largo del tiempo.
Out of Sample como parte de una metodología completa
Cuando empecé a trabajar con sistemas automáticos, muchas decisiones podían parecer subjetivas.
Con el tiempo he intentado convertir cada vez más partes del proceso en algo medible y reproducible.
Out of Sample cumple dos funciones dentro de ese enfoque.
La primera:
validar estrategias fuera de los datos utilizados para desarrollarlas.
La segunda:
investigar qué configuraciones producen sistemas capaces de mantener mejor su comportamiento cuando cambia el mercado.
Y para mí esta segunda parte es especialmente potente.
Porque StrategyQuant deja de ser simplemente una herramienta para generar robots.
Se convierte en una herramienta con la que podemos plantear preguntas, diseñar experimentos y obtener datos para seguir mejorando nuestra metodología.
Si todavía estás aprendiendo las bases del backtesting antes de llegar a este punto, puedes continuar con:
👉 Cómo hacer backtesting con StrategyQuant X paso a paso
Y para entender dónde encaja el Out of Sample dentro de todo el proceso:
👉 Cómo crear estrategias con StrategyQuant X paso a paso
El siguiente paso: empezar a estresar las estrategias
Después de superar los datos desconocidos todavía quedan demasiadas estrategias.
Ahora sabemos que algunas han sido capaces de mantener su ventaja cuando cambiamos de periodo.
Pero todavía no sabemos qué ocurrirá si:
- Modificamos ligeramente el histórico.
- Aumentamos el spread.
- Introducimos más slippage.
- Cambiamos los parámetros de sus indicadores.
Ese será el siguiente nivel del proceso:
las pruebas de robustez y Monte Carlo Stress.
Ahí empezamos realmente a intentar romper las estrategias.
Y ese será el siguiente artículo de esta serie sobre StrategyQuant.
🎓 ¿Quieres aprender este proceso paso a paso?
Si estás empezando en trading algorítmico, puedes comenzar con mi formación gratuita de 10 lecciones.
No necesitas disponer previamente de StrategyQuant. Durante la formación tendrás acceso a una licencia de prueba durante 14 días para poder seguir las prácticas y conocer el software.
👉 Empezar gratis: Trading Algorítmico en 10 lecciones
Si ya conoces StrategyQuant y quieres aprender el proceso completo que utilizo para desarrollar estrategias, realizar pruebas de robustez, construir carteras y hacer seguimiento de los sistemas: